
Alexandre, c’est quoi, le meilleur prompt ChatGPT ?
Le meilleur prompt ChatGPT n'existe pas, parce que l'efficacité d'une formulation dépend de la tâche, du modèle et même de la mise en forme. Les études publiées le confirment. À la place, on construit un système : un brief, un bloc de contexte, des exemples réels, des critères de réussite et un petit jeu de test pour comparer les versions.
Mis à jour le 15 octobre 2026
Le prompt parfait circule sur les réseaux sociaux à peu près chaque semaine.
Il a souvent la même allure : un rôle grandiloquent, quinze consignes en majuscules et la promesse de résultats spectaculaires.
Copiez-le, collez-le, et vous obtenez… un texte moyen. Normal : ce prompt a été écrit pour quelqu'un d'autre.
J'écris pour des marques depuis 2011, et l'IA fait partie de ma boîte à outils.
Dans cet article, je m'appuie sur les études publiées et sur la documentation des éditeurs pour montrer pourquoi la formule magique n'existe pas, et ce que je construis à la place.
Cherchez-vous encore le prompt miracle ?
Pourquoi le meilleur prompt ChatGPT n'existe-t-il pas ?
Parce qu'aucune formulation ne gagne à tous les coups : l'effet d'un prompt dépend de la question posée, du modèle utilisé et de ce qu'on attend comme réponse.
Les chercheurs qui ont testé la chose le disent sans détour.
En mars 2025, une équipe de la Wharton School, avec Ethan Mollick, a publié un rapport au titre parlant : « Prompt Engineering is Complicated and Contingent ».
Ils ont posé 198 questions de niveau doctorat à GPT-4o et GPT-4o mini, 100 fois chacune, avec plusieurs variantes de prompt.
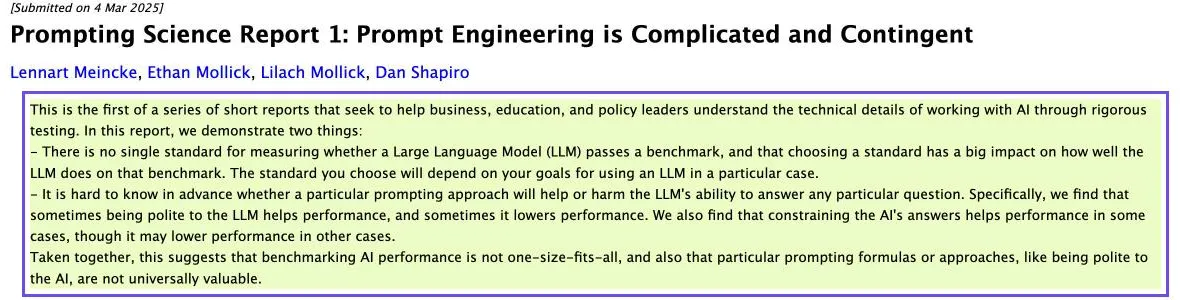
Leur exemple le plus parlant : la politesse.
Commencer par « Please answer the following question » ou par « I order you to answer the following question » change le résultat, mais pas toujours dans le même sens.
Selon la question, être poli aide ou fait baisser la performance.
Les auteurs en tirent une conclusion simple : les formules de prompt, comme la politesse envers l'IA, ne sont pas universellement utiles.
Du coup, un prompt présenté comme « le meilleur » l'est au mieux pour la tâche et le modèle de son auteur.
Pour la vôtre, rien n'est garanti.
Leur test portait sur des questions de sciences à choix multiple, loin du copywriting.
Mais (parce qu'il y a toujours un mais) le principe se transpose sans peine : si une formule ne tient pas sur des questions à réponse unique, elle tiendra encore moins sur un texte de vente, où la bonne réponse n'existe pas d'avance.
Une petite différence de formulation change-t-elle vraiment le résultat ?
Oui, et parfois énormément.
Une étude menée notamment à l'université de Washington a mesuré jusqu'à 76 points d'écart de précision sur un même modèle, en changeant seulement la mise en forme du prompt.
L'étude de Melanie Sclar et ses coauteurs, publiée sur arXiv, ne touche pas au sens des consignes.
Elle change des détails : séparateurs, espaces, majuscules, ponctuation. Et c'est là que tout bascule.
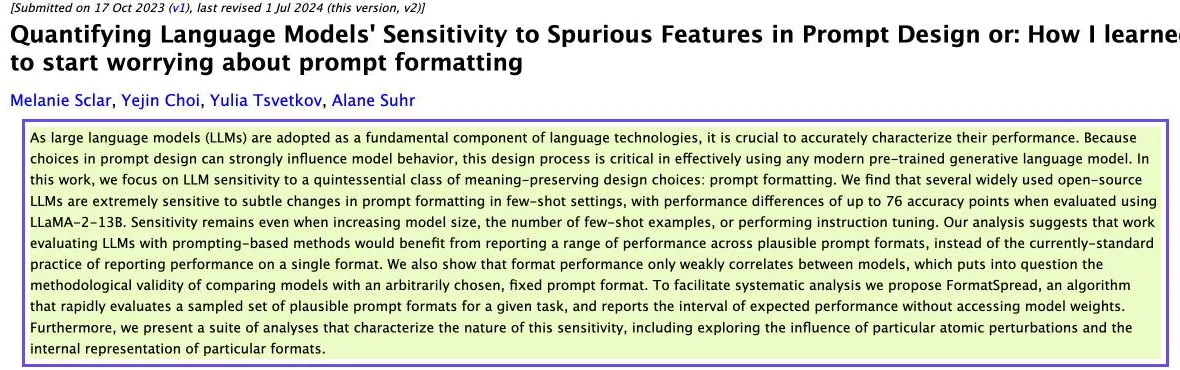
Oui, je sais, LLaMA-2-13B n'est pas ChatGPT, et les modèles ont progressé depuis.
Mais les auteurs notent que cette sensibilité persiste avec des modèles plus gros, avec plus d'exemples ou avec un entraînement aux instructions.
Le problème ne disparaît pas avec la taille.
Leur recommandation vaut pour tout le monde : présenter une fourchette de résultats sur plusieurs formulations plausibles, au lieu d'un score obtenu avec une seule.
Transposé au quotidien d'un rédacteur, ça donne une règle simple. On ne juge jamais un prompt sur un seul essai.
Concrètement, j'en tire trois réflexes. Je lance chaque nouveau prompt au moins trois fois avant de le juger.
Je garde la même mise en forme d'une version à l'autre, pour ne pas mélanger les effets.
Et je me méfie de toute capture d'écran qui montre un seul résultat spectaculaire : elle ne dit rien des dix essais ratés qui l'ont précédée.
Cette instabilité explique aussi une expérience que beaucoup ont vécue : le même prompt donne un excellent texte un jour et un texte plat le lendemain.
Rien de mystérieux. Le résultat varie d'un essai à l'autre, et un seul essai ne dit rien de la qualité d'un prompt.
Que faut-il construire à la place d'un prompt miracle ?
On construit un système de prompt : un brief, un bloc de contexte, des exemples, des critères de réussite et un jeu de test.
Chaque pièce se réutilise d'un texte à l'autre, et c'est elle qui rend les résultats réguliers.
- Le brief. Cible, objectif, message clé, preuves disponibles, action attendue. J'en donne un modèle complet dans mon article sur le brief rédactionnel.
- Le bloc de contexte. Qui parle, à qui, sur quel ton, avec quels mots interdits. Il se rédige une fois par marque.
- Les exemples. Trois textes réels de la marque, qui montrent le ton mieux que n'importe quel adjectif.
- Les critères de réussite. Ce qui fait qu'un résultat est bon : longueur, structure, présence de la preuve, absence de promesse non tenue.
- Le jeu de test. Cinq cas représentatifs sur lesquels je compare chaque nouvelle version du prompt.
La demande elle-même, la ligne « écris-moi un e-mail de relance », devient presque secondaire.
Elle change à chaque fois, le système reste.
C'est pour ça que deux personnes avec le même prompt obtiennent des résultats si différents : l'une a un système derrière, l'autre non.
Un exemple, pour une boulangerie artisanale imaginaire. Le bloc de contexte tient en cinq lignes : « Tu écris pour une boulangerie de quartier à Lyon.
Les lecteurs sont des habitués du quartier. Le ton est chaleureux, sans superlatif.
On dit « levain » et jamais « pain artisanal d'exception ».
Aucun prix ni horaire sans confirmation. » Ajoutez trois posts déjà publiés, et n'importe quelle demande courte produit un texte qui sonne juste dès le premier essai, ou presque.
Le jeu de test est la pièce que presque personne ne construit.
Il suffit pourtant de cinq cas : un sujet facile, un sujet technique, un sujet sensible, un texte court, un texte long.
Si une nouvelle version du prompt fait mieux sur les cinq, je la garde. Sinon, je reviens à l'ancienne.
Comment améliorer un prompt étape par étape ?
On améliore un prompt une variable à la fois, en comparant chaque version sur le même jeu de test.
Changer cinq choses d'un coup ne dit jamais laquelle a fait la différence.
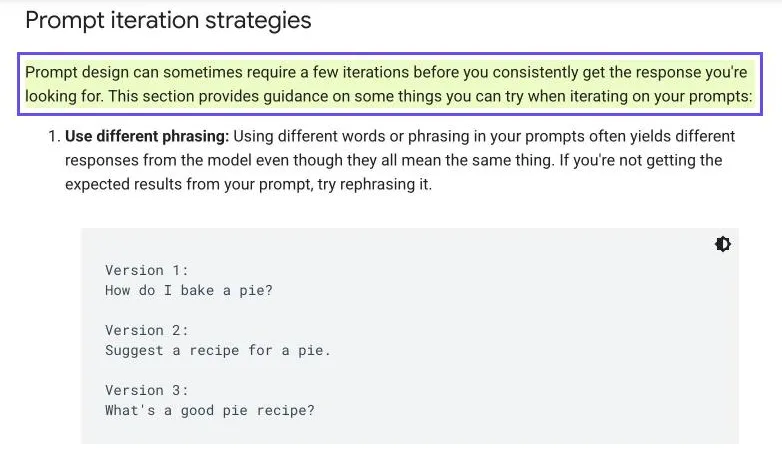
Google le reconnaît dans son guide de conception de prompts pour Gemini, sans fausse modestie :
OpenAI dit la même chose à sa façon.
Sa page de bonnes pratiques conseille de commencer sans exemple, puis d'ajouter des exemples si le résultat ne convient pas.
En clair : on part simple, et on ajoute ce qui manque.
Voici l'ordre dans lequel je touche aux variables, de la plus rentable à la moins rentable :
- la matière : j'ajoute les faits, les avis ou le texte source qui manquaient ;
- les exemples : j'ajoute un texte réel de la marque, ou j'en retire un qui tire le ton vers le bas ;
- le format : je précise la longueur, la structure, le nombre de variantes ;
- les interdits : j'ajoute la formule usée qui revient à chaque essai ;
- la formulation : je reformule la consigne, en dernier, parce que c'est l'effet le moins prévisible.
La formulation arrive en dernier, à cause des études citées plus haut. Retoucher les mots de la consigne donne des effets imprévisibles.
Ajouter de la matière, lui, améliore presque toujours le résultat.
Gardez un petit journal de vos versions de prompt : la date, ce que vous avez changé, et le résultat sur vos cinq cas de test. Au bout de trois versions, vous saurez quelles modifications servent vraiment.
Comment savoir si un prompt est efficace ?
Un prompt est efficace quand il donne un résultat acceptable sur tous les cas du jeu de test, pas un résultat brillant sur un seul.
La régularité compte plus que le coup d'éclat.
Le tableau confronte les croyances les plus répandues sur le prompt idéal à ce que disent les sources, et à ce que j'en fais au quotidien.
| Ce qu'on croit | Ce que disent les sources | Ce que je fais |
|---|---|---|
| La politesse améliore les réponses | Elle aide ou nuit selon la question (Wharton, 2025) | J'écris normalement, sans formule magique |
| La mise en forme ne compte pas | Jusqu'à 76 points d'écart sur un même modèle (Sclar et al.) | Je garde une mise en forme stable d'une version à l'autre |
| Un bon prompt marche sur tous les outils | La performance d'un format est faiblement corrélée d'un modèle à l'autre (Sclar et al.) | Je reteste mes prompts quand je change d'outil |
| On trouve le bon prompt du premier coup | Il faut parfois plusieurs itérations (Google) | Je compare chaque version sur cinq cas |
| Plus le prompt est long, mieux c'est | OpenAI demande de réduire les descriptions floues et imprécises | Je coupe ce qui ne change pas le résultat |
La dernière ligne mérite un mot. Un prompt de deux pages bourré d'adjectifs donne l'impression d'être complet.
En réalité, une consigne floue reste floue, même répétée trois fois.
Je préfère cinq lignes précises et trois exemples réels.
Pour vérifier l'efficacité, je relis chaque résultat avec mes critères écrits sous les yeux.
Un critère se coche ou ne se coche pas : la preuve est-elle présente, la longueur respectée, la formule interdite absente ?
Le ressenti vient après.
Pour un e-mail de relance, mes critères ressemblent à ça : moins de 120 mots, un objet de moins de 50 caractères, une seule demande claire, aucune fausse urgence, et le nom de l'offre écrit comme la marque l'écrit.
Cinq critères, cinq cases. Si une case reste vide, la version repart en atelier.
Un prompt qui marche sur ChatGPT marche-t-il sur Claude ou Gemini ?
Pas forcément. L'étude de Sclar et al. montre que la performance d'un format de prompt n'est que faiblement corrélée d'un modèle à l'autre.
Ce qui marche sur un modèle peut décevoir sur un autre.
Les éditeurs le savent, puisque chacun publie son propre guide : OpenAI pour ChatGPT, Google pour Gemini, Anthropic pour Claude.
Les grands principes se recoupent (être précis, donner du contexte, montrer des exemples), mais les détails diffèrent d'un guide à l'autre.
Du coup, quand je change d'outil, je reprends mon jeu de test et je compare.
Le système (brief, contexte, exemples, critères) se transporte tel quel. Seule la demande finale demande parfois un ajustement.
Je compare les deux outils plus en détail dans mon article ChatGPT ou Claude.
Il y a une autre raison de retester : les modèles changent sous le même nom.
Un outil peut passer à une nouvelle version du jour au lendemain, et vos prompts habituels se mettent à répondre autrement.
Le jeu de test sert alors de contrôle de non-régression, comme en développement logiciel.
Dans sa page de bonnes pratiques, OpenAI demande de réduire les descriptions floues et imprécises. Son exemple : remplacer « assez court, quelques phrases seulement » par « un paragraphe de 3 à 5 phrases ».
Un système bien construit est donc indépendant de l'outil.
C'est un vrai avantage le jour où vous changez d'abonnement, ou le jour où votre outil habituel change de modèle sans vous prévenir.
Les listes de « meilleurs prompts » sont-elles inutiles ?
Non, elles servent de point de départ, à condition de les brancher sur votre propre système.
Une liste donne des idées de tâches. Votre brief et vos exemples font le reste.
J'en publie une moi-même : mes 40 prompts ChatGPT pour le marketing, classés par étape du tunnel.
Ils sont volontairement courts. Chacun suppose qu'on colle avant lui le bloc de contexte de la marque, sinon il produit un texte générique, comme les autres.
Méfiez-vous des listes qui promettent des résultats chiffrés sans dire comment elles les ont mesurés.
Au vu des études citées plus haut, une promesse de type « +300 % de qualité » ne veut rien dire (sur quelle tâche, quel modèle, combien d'essais ?).
Une promesse sérieuse vient avec son protocole, comme dans les rapports cités ici, qui donnent le modèle, le nombre de questions et le nombre d'essais.
Le métier de rédacteur bouge dans ce sens : moins de temps passé à chercher la formule, plus de temps passé à construire la matière que l'IA va utiliser.
J'en parle dans mon article sur ce qui change dans le copywriting, et la méthode complète est dans mon guide du copywriting avec l'IA.
Le prompt est la partie la plus visible du travail avec l'IA, et la moins importante. Ce qui fait la qualité d'un texte, c'est la matière qu'on donne avant et la relecture qu'on fait après.
Par où commencer votre système de prompt ?
Indiquez ce que vous avez déjà et votre usage principal : l'outil vous dit quelle pièce construire en premier.
Ce qu'il fallait retenir
- Aucune formule de prompt ne marche à tous les coups, d'après le rapport de Wharton publié en 2025.
- La seule mise en forme d'un prompt peut faire varier la précision jusqu'à 76 points sur un même modèle.
- Un prompt se juge sur plusieurs essais et plusieurs cas, jamais sur un seul résultat.
- À la place d'un prompt miracle, on construit un système : brief, contexte, exemples, critères, jeu de test.
- On améliore un prompt une variable à la fois, en commençant par la matière fournie.
- Un prompt performant sur ChatGPT doit être retesté sur Claude ou Gemini.
- Les listes de prompts servent de point de départ, branchées sur votre propre brief.
Questions fréquentes sur le meilleur prompt ChatGPT
Existe-t-il un prompt ChatGPT parfait ?
Non. Le rapport de Wharton publié en 2025 montre qu'il est difficile de savoir à l'avance si une formulation aidera ou nuira, selon la question posée. Un prompt efficace dépend de la tâche, du modèle et du contexte fourni.
Faut-il être poli avec ChatGPT ?
Ça ne change rien de façon régulière. Dans le rapport de Wharton, la politesse a parfois amélioré et parfois dégradé les réponses, selon la question. Écrivez naturellement et concentrez-vous sur le contexte.
Comment améliorer un prompt qui donne de mauvais résultats ?
Changez une seule chose à la fois et comparez sur les mêmes cas de test. Commencez par ajouter de la matière (faits, exemples), puis précisez le format, et reformulez la consigne en dernier.
Un prompt long est-il meilleur qu'un prompt court ?
Pas en soi. OpenAI demande de réduire les descriptions floues et imprécises. Un prompt précis de quelques lignes, avec des exemples réels, donne souvent mieux qu'un long texte rempli d'adjectifs.
Pourquoi le même prompt donne-t-il des résultats différents ?
Parce que les modèles produisent des réponses variables d'un essai à l'autre, et qu'ils sont sensibles à de petits détails de formulation. C'est pour ça qu'il faut juger un prompt sur plusieurs essais.
Qu'est-ce qu'un prompt efficace pour un rédacteur ?
C'est une demande courte branchée sur un système : un brief, un bloc de contexte de la marque, des exemples de textes et des critères de réussite. Le système se réutilise d'un texte à l'autre.
Construire votre système de prompt avec un professionnel
Vous voulez des résultats réguliers avec ChatGPT ou Claude, sans chercher chaque jour le prompt parfait ?
Je construis avec vous le brief, le bloc de contexte, les exemples et le jeu de test, sur vos propres textes.